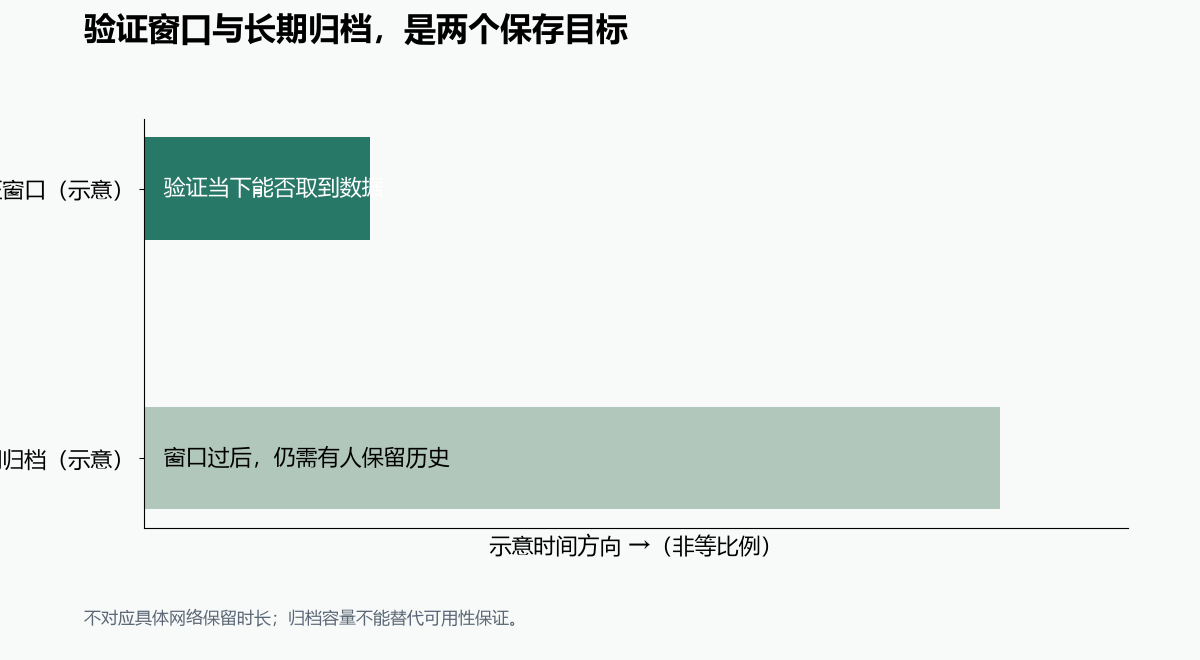
数据可用性和永久存储都关心“数据还在不在”,但判断的是两件不同的事。数据可用性问的是:在验证某个区块所需的窗口内,完整数据能不能被网络参与者获得并核查,使缺数据的区块不会被当作有效区块接受。永久存储问的是:过了很久之后,还能不能把这段历史数据取回来。前者服务于当下的验证,后者服务于长期的查询与同步。把两者混为一谈,最容易产生的错误是以为“只要存下来了,数据可用性就没问题”。
数据可用性带有时间边界,而且它的保证强度取决于具体机制。全节点下载并执行区块数据,可以直接确认数据存在;轻客户端或 rollup 不下载全部数据,就需要采样、委员会或证明等额外手段来建立信心。委员会是由一组受信或受激励的参与方对数据存在作出担保,采样则是通过随机抽取数据片段来概率性地判断整体是否可用,两者的信任假设并不相同。因此,“有数据可用性方案”不等于“任何设计下都保证缺数据不会被接受”,要具体看它依赖的是哪一层验证。
一个具体例子能划清边界。假设某条链约定验证窗口为 10 天,出块间隔 12 秒,每个区块产生 1 MB 需要核查的数据。窗口内需要保障可获取的数据量约为 1 MB ×(10×86400÷12)≈ 72 GB。这是数据可用性一侧要覆盖的规模,只针对验证窗口,不代表这些数据会被永久保存。窗口结束后,这段数据能否找回,取决于归档节点或归档服务等另外的角色,而不是数据可用性机制本身。这个计算是纯假设的教学示例,不指向任何具体网络的参数。
可以用下表区分两类需求:
| 判断维度 | 数据可用性 | 永久存储 |
|---|---|---|
| 要回答的问题 | 验证窗口内数据能否获得并核查 | 很久以后能否取回历史数据 |
| 时间边界 | 有明确窗口 | 长期,按保存策略而定 |
| 服务对象 | 验证区块、发现缺数据 | 同步、审计、历史查询 |
| 典型承担者 | 全节点、采样机制、委员会 | 归档节点、归档服务、去中心化存储 |
| 不保证什么 | 不保证永远保存全部历史 | 不保证验证窗口内随时可取 |
判定时可以先问三个问题。第一,这段数据是为了验证“新块是否有效”吗?如果是,它属于数据可用性的范畴。第二,验证发生在什么时间窗口内,窗口过后由谁负责?如果没人负责,就不能把“已上链”当成“永久保存”。第三,需求是“现在能验证”还是“几年后能查”?前者看数据可用性机制,后者看归档与存储安排。三问下来,多数混淆会自然分开。
做容量规划时也要分开算。仍用上面的假设:验证窗口内约 72 GB 是数据可用性侧的规模;若要额外保存三年历史,按同样出块速度,总量约为 1 MB ×(3×365×86400÷12)≈ 7.9 TB。两个数字回答的是两个问题,不能互相替代。存得多,只能说明存储侧投入大,不能推出验证窗口内一定拿得到数据;反过来,验证窗口内可用,也不意味着三年后还能查到。
评估时还要看机制而不是看宣传。判断数据可用性,应看它是否提供了可核查的手段:全节点是否下载并执行区块数据,是否采用随机采样,委员会的成员与激励如何设定,出现缺数据时由谁发现、如何处置。判断永久存储,则要看保存策略、冗余方式、取回路径和退出安排。两套标准混用,就会得出“存了很多,所以数据可用性没问题”的错误结论。
因此,选型时不要只问“存了多少”。先明确要的是验证窗口内的可获得性,还是历史数据的长期可取回性;前者按数据可用性机制评估,后者按归档与存储服务评估。两者可以配合,但不能互相冒充。